新一代信创规则引擎平台


那些被“先放一边”的发票——一个交付工程师的复盘笔记
2026-11-06
上个月去一家客户那儿,财务共享中心的工位上贴了张手写便签:「褶皱票、歪的票、盖章盖住金额的票,先放一边,最后弄。」
我问她为什么要放一边。她说,机器认不出来,我得自己一个个敲。
那摞票三百多张,全是机器认不出来的"疑难杂症"。她每天为此多干两个小时,而且没人觉得这有什么不对——系统认不出的票,人就得出面,天经地义。
这个画面我记了很久。因为过去两年,我们团队几乎把全部精力都花在这件事上——怎么让机器把这些"不像发票的发票"认对。
这篇不写架构图,写我们踩过的坑。
坑一:以为OCR就够了
最早我们走的是经典路线:OCR+正则+版式模板。
标准增值税专票、电子发票,效果很好,能到95%以上。但客户真正头疼的恰恰是"非标件"——差旅的定额发票、手写的收据、老式机打票、被公章盖住半边的票、扫描时歪了十几度的票。
版式一变,模板就崩。我们做的模板越多,维护成本越吓人。客户的票种从几十种涨到几百种,新增一个版式,调模板要一天。
这条路的天花板大概在60%~75%。不是技术不行,是规则写不尽现实。
坑二:以为大模型能一把梭
后来大模型火了,我们也很兴奋:把OCR文本整段丢给模型,让它自己抽。
准确率一下跳到85%~92%,客户也满意。
然后出事了。
有一次对账,系统抽出来一张发票的价税合计是128,600.00,实际票面是12,860.00——多了一个零。这张票要是照这个数进了付款流程,就是一笔真金白银的多付。金额、税额、不含税额三个数对不上,模型还是给了一个"看起来很自信"的结果。
财务总监问我一句话:它错了,是它告诉我,还是我告诉它?
我答不上来。
大模型的问题不是不准,是不确定。它给你一个答案,但不保证这个答案在数学上成立。财务场景里,一个编造的金额,比十个识别不出的字段危险得多。
坑三:以为加个规则拦一下就行
于是我们加了规则引擎:金额勾稽、税号格式校验、发票号重复检查。
结果自动通过率反而掉了——因为规则只会"否",不会"改"。一张票被拦下来,还是得人来看。
那段时间我很沮丧:模型识别得不错,规则也很严格,可整体效率就是上不去。转机来得纯属偶然——有一次复现问题,我随手把规则报错的内容,原样贴进了和模型的对话里。
想通的一件事:让规则教模型再抽一次
改进的办法,简单到不像话。
把规则校验失败的结构化原因,原样回喂给模型——
rule_id: INV-A01
reason: 不含税金额+税额 与 价税合计不相等
expected: 12860.00
actual: 128600.00
再跟一句:请仅修正与规则冲突的字段,其余字段保持不变,重新输出JSON。
模型第二次给出来的结果是12,860.00。
就这么一个动作,自动通过率抬了5~10个点。后来我们把所有失败场景都接上了这条回路——模型每错一次,下一次就更接近对。
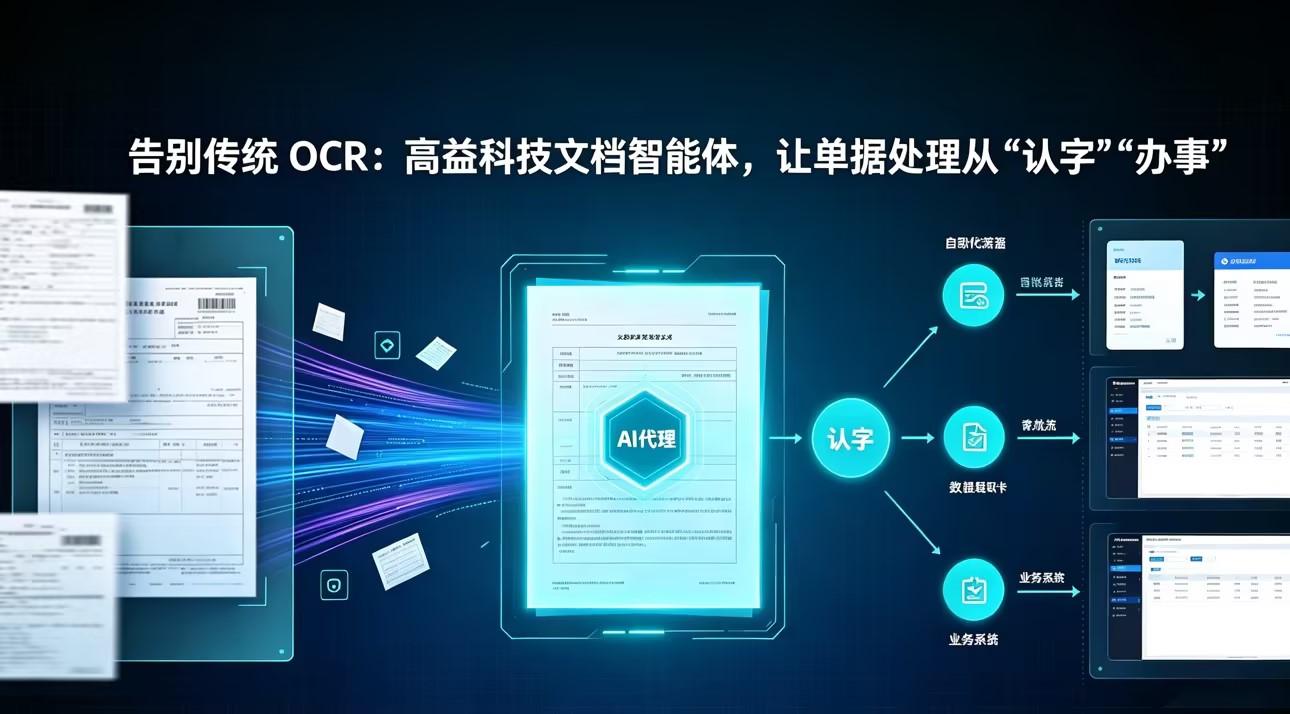
我们把这条链路固化成了一句话:OCR读字,大模型读懂,规则判对,人兜底。
不是四个环节串起来就行,而是必须闭环——规则不只是门卫,它还是老师。它的失败原因,是模型第二次思考时最好的提示词。
这条流水线里还有一条分工红线,我们写得很硬:大模型负责读懂非标表述、对齐字段,但不许直接决定入库、不许绕过勾稽;规则引擎负责金额勾稽、税号格式、重复检查,但不许理解模糊扫描件、不许猜字;人只改规则仍未通过的标红字段,不整单重录。谁越线,系统就拒绝谁的输出。听起来苛刻,但财务数据面前,苛刻就是安全。
两个"笨办法",比换更大的模型管用
模型迭代到今天,很多人以为识别率的钥匙在模型侧。我们试下来,有两件事比换模型有效得多,都是笨办法。
第一个是版式分治。
非标票听起来千奇百怪,其实不是无限随机——把几百张票摊开看,无非是几十个版式家族。我们对OCR全文做聚类,每类打一个版式标签,每个家族配两三条样例;新票进来先判家族,再走对应的抽取策略。新发现一个版式,人工标注两张样例就能启用。这件事没有任何技术含量,但它把"一个模型对付全世界"变成了"一群小模型各管一摊",准确率实打实抬了一截。
第二个是双通道验证。
对金额、税号、发票号这几个要命的字段,我们不只走文本抽取一条路,还会把票面那个区域裁出来,让视觉模型直接"看"一遍。两条路的结果一致,置信度上调;不一致,降级送人工。相当于给关键字段上了双保险——错一个零这种事,基本逃不过去。
剩下那5%,交给一条分级流水线
每一单进来,系统先给一个置信度,处置分四级:L1高置信直过;L2中置信放行,但抽检5%;L3低置信进人工;命中拒绝规则的,直接退回。
人工复核的界面也讲究:左边是原图,带着OCR高亮框;右边是结构化表单,低置信字段标红。复核的人只改标红的字段,整单不用重录——一张票从三分钟压到三十秒,靠的就是这个。
还有个闭环:每一次人工修正,都会写回样本库,变成下次抽取的few-shot。系统越用越懂这家公司的票。所谓持续学习,落点其实很朴素:让每一次人工劳动都留下复利。
现在的样子
改造之后,现在的状态大概是这样:
关键字段准确率:95%以上
整单自动通过率:80%左右
人工只处理标红的低置信字段,一张票从3分钟降到30秒
每一单都留痕:原图坐标、OCR结果、模型输出、命中规则,审计随时能倒查
对了,那位财务总监后来又问过我一次那个问题——它错了,是它告诉我,还是我告诉它?这回我能答了:是它先告诉她的。错在哪、为什么错、该改哪个字段,界面上一目了然。她把那张便签撕了。
后来常被问到的三个问题
"上了大模型,OCR是不是可以扔了?"
不能。OCR负责把字读出来并给出坐标,大模型负责理解这些字是什么意思。没有OCR的坐标,人工复核时连"标红哪个字段"都做不到——只能让财务从头到尾重录一遍,那就又回到老路了。
"准确率都95%了,是不是可以全自动?"
恰恰相反。剩下那5%,往往是最要命的5%——错的常常就是金额。所以我们不搞一刀切的全自动,而是把处置分成四级:直过、放行加抽检、人工、拒绝。分级听起来不如"全自动"性感,但它敢写进合同。
"数据安全怎么保证?"
发票影像加密存储,模型调用前对敏感字段脱敏;有要求的客户直接私有化部署,模型和数据都不出域。这一点对金融客户尤其重要——识别率是效率问题,数据出不出域是资格问题。
落地节奏:四步走,每一步都有验收线
这件事我们分四步走,每一步都定了验收标准,不给"再看看"留空间:
P0,POC,两到三周。挑100张最烂的票,出识别报告,先验证能不能到85%。通不过,就别往下走。
P1,MVP,四到六周。OCR、大模型、规则引擎的流水线搭起来,复核界面跟上,关键字段冲到90%。
P2,量产,六到八周。版式库、批量队列、监控告警补齐,自动通过率做到80%。
P3,持续优化,长期。样本回流、模型微调、同义词词典,往95%以上爬。
每一步交什么、到什么数,都写进合同。项目最怕的不是慢,是不知道自己走到哪一步了。
如果你也在做这件事
三条建议,都是我交过学费的:
1.别拿标准票当考卷。标准票测出99%也没意义,真实世界里先崩的就是最烂的那批票。
2.别指望一个模型解决所有问题。版式分治、双通道验证(文本抽取+视觉直读比对),这些"笨办法"比换个更大的模型有效得多。
3.规则要能回喂。只拦不修的规则,本质上是在把机器的错误转成人力的成本。
最后说句实在的:这件事没有银弹。95%不是靠某个模型版本达成的,是靠"理解"和"约束"两个引擎咬着转出来的。
如果你手上也有那摞"先放一边"的票,欢迎找我聊聊。踩过的坑我都记得,摊开给你看,总比你自己再踩一遍强。
文章注释说明:© 2026 深圳高益科技有限公司.All Rights Reserved.转载请注明来源。